La competencia por dominar la infraestructura de inteligencia artificial está entrando en una nueva etapa. Durante los últimos años, NVIDIA se ha consolidado como uno de los principales proveedores de procesadores especializados en IA, gracias a sus potentes aceleradores utilizados para entrenar y ejecutar modelos avanzados. Sin embargo, gigantes tecnológicos como Microsoft, Google y Amazon están desarrollando alternativas propias para reducir su dependencia de proveedores externos.
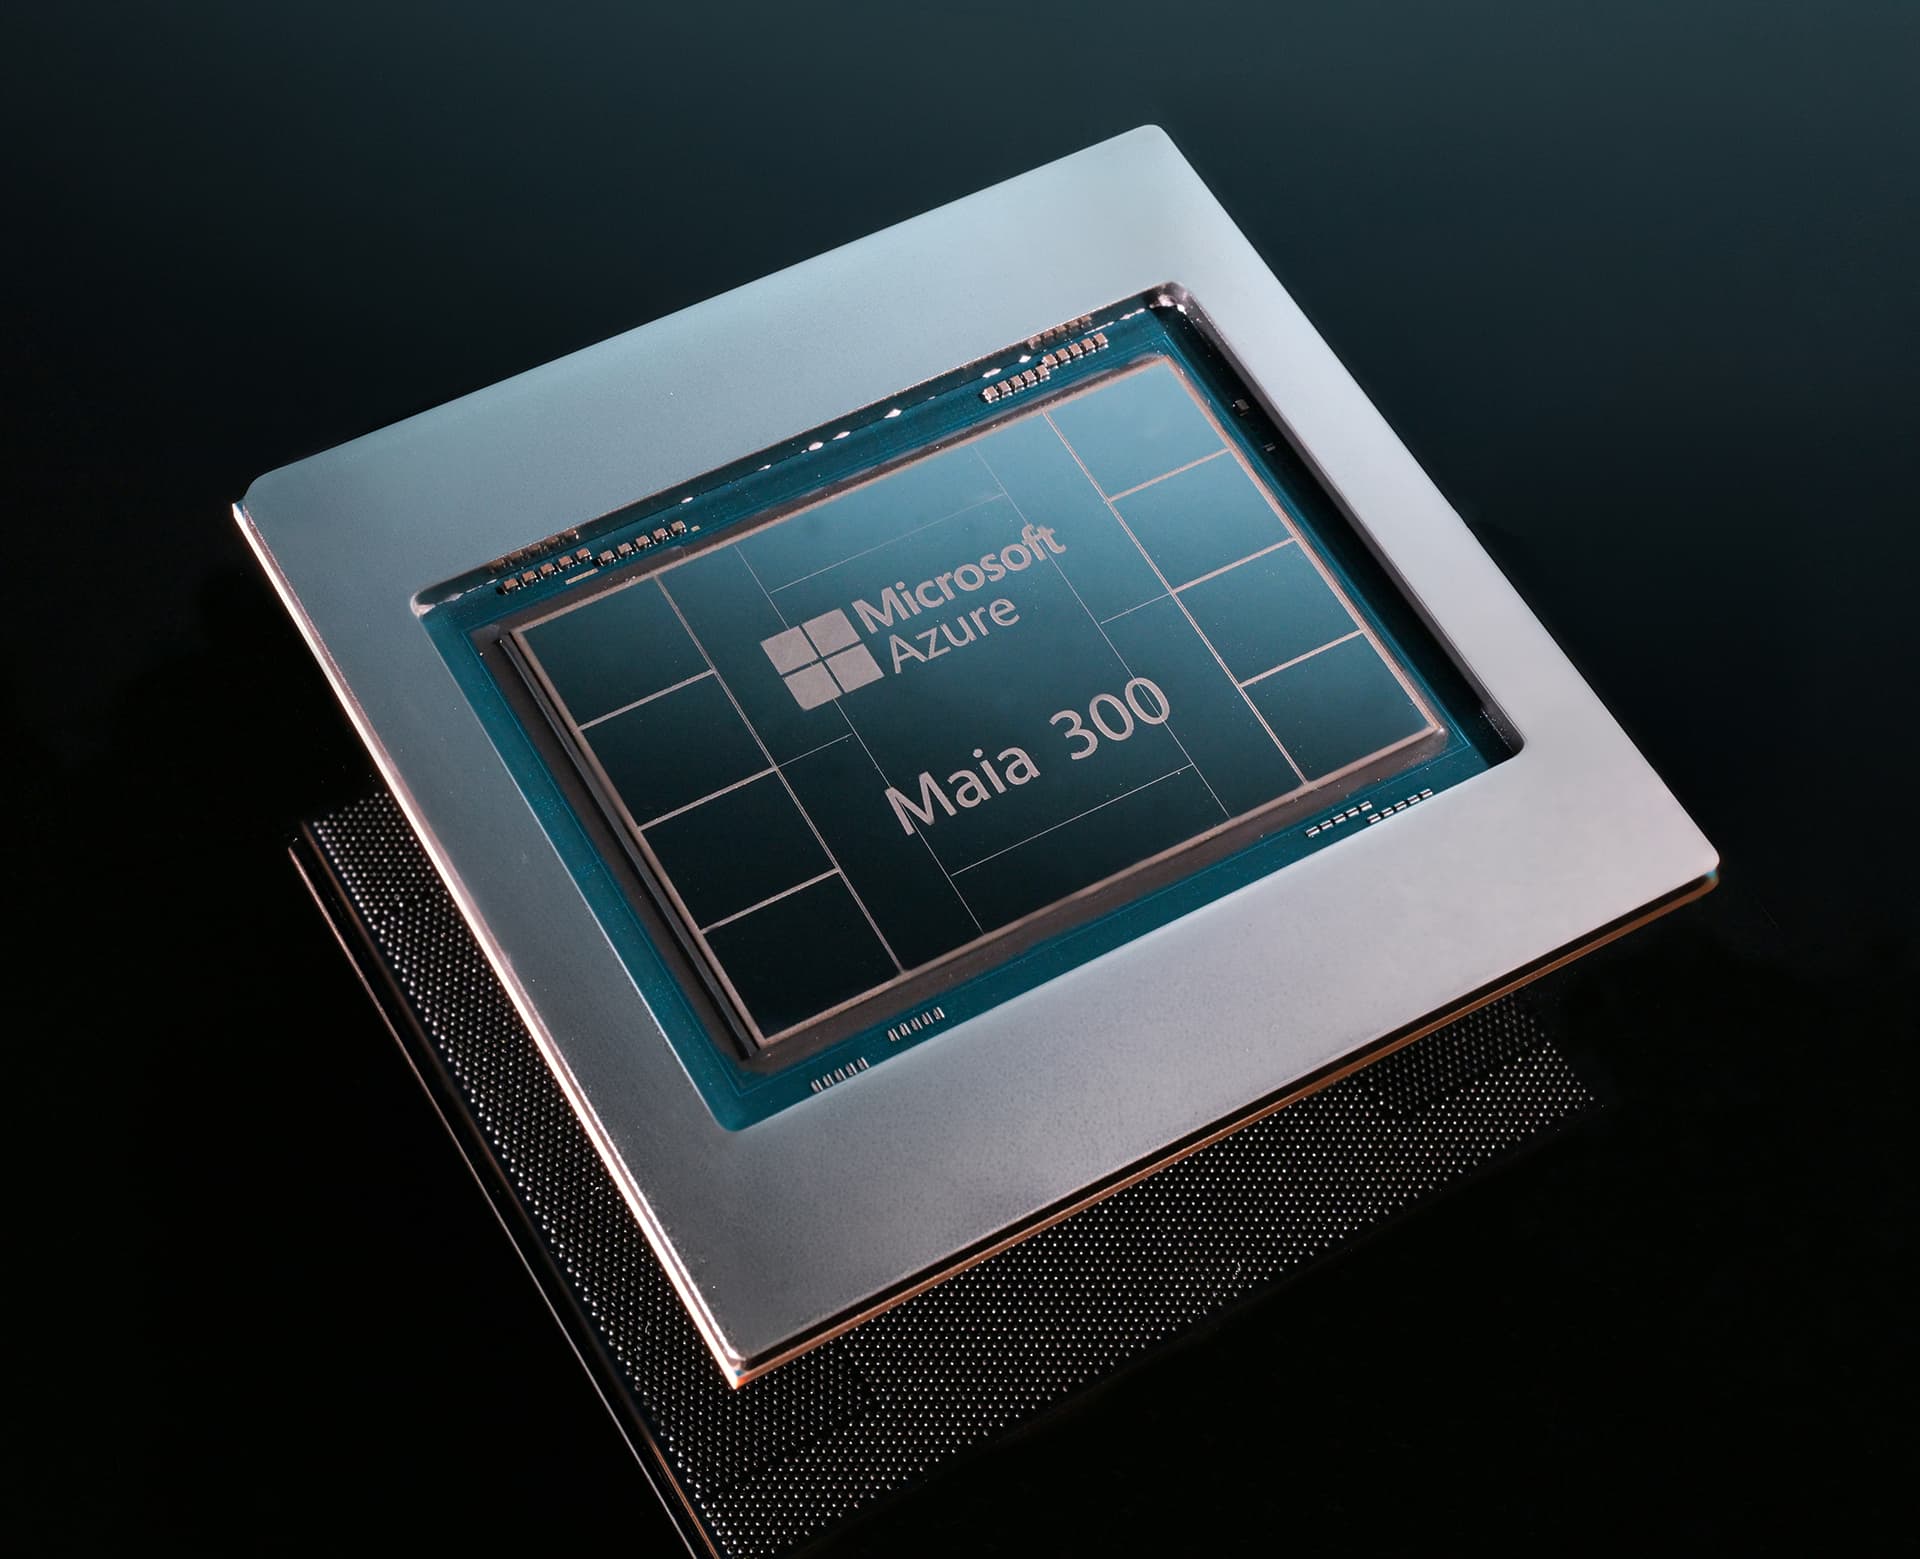
En este escenario, Microsoft ha anunciado Maia 300, la tercera generación de su familia de aceleradores diseñados específicamente para inteligencia artificial. Según la hoja de ruta presentada por la compañía el 12 de octubre de 2026, el nuevo sistema comenzará a desplegarse en producción durante 2027 y formará parte de una estrategia mucho más ambiciosa: convertir Maia en la infraestructura principal para ejecutar tareas de inferencia en sus productos y servicios de IA.
La apuesta no consiste simplemente en fabricar otro procesador. Microsoft busca controlar una parte cada vez mayor de la tecnología que sostiene servicios como Copilot y las soluciones de inteligencia artificial disponibles a través de Azure.
Además, la compañía contempla ampliar esta infraestructura hasta alcanzar despliegues de varios gigavatios, una escala que refleja la enorme cantidad de energía y capacidad computacional necesaria para responder a la creciente demanda mundial de inteligencia artificial.
¿Por qué Microsoft quiere reducir su dependencia de NVIDIA?
Cada vez que una persona utiliza un chatbot, genera una imagen o solicita un análisis mediante inteligencia artificial, numerosos cálculos se ejecutan en servidores especializados.
Gran parte de estas operaciones requieren aceleradores diseñados para procesar grandes cantidades de datos de manera paralela. NVIDIA ha desarrollado un ecosistema de hardware y software que la convierte en uno de los actores más importantes de este mercado.
Sin embargo, depender de un proveedor externo implica varios desafíos para empresas que operan centros de datos a escala mundial:
- El costo: A medida que aumenta la demanda de inteligencia artificial, también crece la inversión necesaria para adquirir procesadores, construir centros de datos, instalar sistemas de refrigeración y mantener la infraestructura operativa.
- La disponibilidad: Cuando numerosos competidores necesitan adquirir equipos similares, la capacidad de ampliar rápidamente los servicios puede depender de los tiempos de suministro de terceros.
- Estrategia: Tener control sobre el diseño de los procesadores permite adaptar el hardware a las necesidades específicas de cada plataforma.
Microsoft busca aprovechar esta última ventaja con su familia Maia.
Maia 300: la tercera generación de aceleradores de Microsoft
El proyecto Maia no comienza con este anuncio.
- Maia 100 (2023): Microsoft presentó su primer acelerador como parte de sus esfuerzos por desarrollar infraestructura especializada para cargas de trabajo de inteligencia artificial.
- Maia 200 (enero de 2026): Una generación orientada a mejorar la ejecución de modelos y optimizar el funcionamiento de sus servicios. Según la información proporcionada por la compañía, Maia 200 ya se utiliza para procesar cargas de trabajo reales, incluidas operaciones relacionadas con Microsoft Copilot.
Esa experiencia constituye una base importante para Maia 300.
En lugar de diseñar procesadores únicamente a partir de previsiones teóricas, Microsoft puede utilizar información obtenida del funcionamiento de sus propios servicios para identificar necesidades de rendimiento, eficiencia y escalabilidad.
Con Maia 300, la compañía pretende avanzar hacia una infraestructura de inferencia cada vez más integrada y optimizada para sus plataformas.
¿Qué es la inferencia y por qué resulta tan importante?
Para comprender la estrategia de Microsoft, es necesario distinguir dos etapas fundamentales de la inteligencia artificial: entrenamiento e inferencia.
Entrenamiento: Es el proceso mediante el cual un modelo aprende patrones y desarrolla capacidades a partir de grandes cantidades de datos. Requiere una enorme potencia computacional y puede prolongarse durante períodos considerables, dependiendo de la complejidad del modelo.
Inferencia: Ocurre después, cuando el modelo ya entrenado recibe una solicitud y genera una respuesta. Por ejemplo, cuando alguien le pide a Copilot que resuma un documento, redacte un correo o analice una tabla, se ejecutan operaciones de inferencia.
Aunque cada petición individual pueda parecer relativamente sencilla, la situación cambia cuando millones de usuarios interactúan simultáneamente con estos sistemas. Cada respuesta consume recursos computacionales, memoria y energía.
Por eso, mejorar la eficiencia de la inferencia puede representar un ahorro significativo cuando los servicios operan a escala global. Microsoft quiere que Maia se convierta en uno de los pilares de esa operación.
Una arquitectura diseñada para mejorar la eficiencia energética
Uno de los aspectos más relevantes de Maia 300 es su enfoque en el rendimiento por unidad de energía consumida.
- Rendimiento por megavatio: Microsoft afirma que el sistema está diseñado para ofrecer un 40 % más de tokens por megavatio en comparación con sistemas líderes basados en GPU. Los tokens son las unidades de información que procesan los modelos de lenguaje. Por tanto, generar más tokens utilizando una cantidad similar de energía puede permitir atender más solicitudes sin aumentar proporcionalmente el consumo eléctrico.
- Escalabilidad por rack: La compañía también señala que una configuración completa de 96 aceleradores Maia 300 podría alcanzar hasta siete veces el rendimiento de generación de tokens por rack de Maia 200.
Estas cifras corresponden a las estimaciones y comparaciones presentadas por Microsoft. Todavía deberán evaluarse cuando Maia 300 entre en producción y existan resultados independientes en diferentes cargas de trabajo.
¿Qué características técnicas tendrá Maia 300?
Microsoft ha revelado varios detalles que permiten comprender cómo pretende alcanzar esas mejoras. Maia 300 estará diseñado para cargas de trabajo exigentes, especialmente aquellas relacionadas con razonamiento de contexto extenso, conversaciones que requieren respuestas rápidas y agentes de inteligencia artificial capaces de ejecutar tareas de múltiples pasos.
| Característica / Componente | Especificación Anunciada |
| Arquitectura | Múltiples chiplets |
| Memoria | 8 conjuntos de HBM4 |
| Ancho de banda máximo | 18 TB/s |
| Potencia de diseño térmico (TDP) | 950 W por acelerador |
| Proceso de fabricación | N2P de TSMC |
| Configuración de rack | 96 aceleradores por rack |
| Capacidad agregada por rack | 27,6 TB de memoria HBM |
| Consumo de diseño por rack | Aprox. 167 kW |
La importancia de estas especificaciones no reside únicamente en alcanzar velocidades elevadas. También está en conseguir que numerosos procesadores trabajen coordinadamente, reduciendo los movimientos innecesarios de datos y aprovechando mejor la memoria disponible.
Centros de datos de varios gigavatios: la escala de la nueva IA
Otro de los puntos más llamativos del anuncio es la intención de Microsoft de ampliar la infraestructura Maia hasta alcanzar despliegues de varios gigavatios a partir de 2027.
Un gigavatio equivale a mil megavatios. Se trata de una magnitud considerable que permite comprender la dimensión energética de los centros de datos destinados a inteligencia artificial. Sin embargo, es importante aclarar que esta cifra se refiere a la escala de infraestructura anunciada, no al consumo de un único procesador ni de un solo centro de datos.
El crecimiento de estas instalaciones también plantea desafíos relacionados con:
- Suministro eléctrico
- Refrigeración
- Disponibilidad de agua en determinados sistemas
- Construcción de nuevas instalaciones
Por eso, la eficiencia energética se está convirtiendo en un factor tan importante como la potencia de cálculo. Un procesador capaz de realizar más operaciones útiles por unidad de energía puede mejorar los costos operativos y permitir una mayor capacidad de servicio dentro de las limitaciones físicas de un centro de datos.
Google y Amazon también desarrollan sus propios aceleradores
Microsoft no es la única compañía que busca reducir su dependencia de los fabricantes tradicionales de GPU.
- Google: Lleva años desarrollando sus unidades de procesamiento tensorial, conocidas como TPU, diseñadas para acelerar operaciones de aprendizaje automático y ejecutar modelos de inteligencia artificial dentro de su infraestructura.
- Amazon Web Services (AWS): Ha desarrollado familias de procesadores especializados, como Trainium e Inferentia, orientados a distintas necesidades de entrenamiento e inferencia.
Aunque sus arquitecturas y estrategias son diferentes, estas iniciativas comparten un objetivo: disponer de hardware optimizado para las necesidades de sus propias plataformas.
La tendencia muestra cómo los grandes proveedores de servicios en la nube están pasando de comprar exclusivamente capacidad de procesamiento a participar directamente en el diseño de los chips que necesitan.
¿Está realmente amenazado el dominio de NVIDIA?
La aparición de Maia 300 no significa que NVIDIA vaya a perder inmediatamente su posición en el mercado.
- Ventajas de NVIDIA: La compañía dispone de una amplia experiencia en aceleradores de inteligencia artificial, un ecosistema de desarrollo consolidado y tecnologías de interconexión que permiten construir sistemas de procesamiento a gran escala. Además, sus procesadores se utilizan en una amplia variedad de aplicaciones, desde entrenamiento de modelos hasta investigación científica y servicios comerciales.
- Rol de los chips personalizados: Los chips personalizados de Microsoft, Google y Amazon representan una alternativa especialmente atractiva para determinadas cargas de trabajo internas, pero no necesariamente reemplazan todas las funciones que desempeñan las GPU de propósito más general.
El impacto más importante podría aparecer en el crecimiento futuro del mercado. Si las grandes empresas tecnológicas consiguen ejecutar una parte considerable de sus servicios de inferencia utilizando procesadores propios, podrían necesitar comprar una proporción menor de aceleradores externos para esas tareas específicas.
Esto no implica necesariamente una caída inmediata en las ventas de NVIDIA, pero sí representa una transformación en la manera en que sus principales clientes planifican sus inversiones.
¿Qué beneficios podría tener para los usuarios?
Aunque Maia 300 está pensado para centros de datos y no para computadores personales, sus avances podrían terminar influyendo en la experiencia de los usuarios.
Una infraestructura de inferencia más eficiente puede ayudar a:
- Reducir el costo de ejecutar modelos avanzados.
- Aumentar la cantidad de solicitudes atendidas simultáneamente.
- Mejorar la disponibilidad de servicios.
- Facilitar aplicaciones que requieren interacciones prolongadas, como asistentes capaces de analizar documentos extensos, agentes de programación y herramientas empresariales que ejecutan procesos de múltiples pasos.
Sin embargo, estos beneficios no están garantizados automáticamente. La velocidad final de una aplicación también depende del modelo utilizado, las redes, la configuración del servicio y las decisiones comerciales de cada proveedor. Por tanto, habrá que esperar al despliegue de Maia 300 para conocer cuánto de su rendimiento técnico se traduce en mejoras perceptibles para los usuarios.
Conclusión: Microsoft quiere controlar el futuro de su infraestructura de IA
El anuncio de Maia 300 confirma que la competencia por la inteligencia artificial ya no se limita a desarrollar modelos cada vez más avanzados. También se está librando una batalla por controlar los procesadores, la memoria, las redes y los centros de datos necesarios para ejecutarlos.
Con Maia 300, Microsoft pretende dar un paso importante hacia una infraestructura propia, optimizada para la inferencia y diseñada para funcionar a una escala considerablemente mayor. Su despliegue comenzará en 2027, por lo que todavía es pronto para determinar su impacto real sobre NVIDIA y el mercado de aceleradores.
Sin embargo, la dirección estratégica resulta evidente: Microsoft quiere que una parte fundamental de la inteligencia artificial que ofrece a millones de usuarios funcione sobre tecnología diseñada por la propia compañía. Y con Google y Amazon avanzando en iniciativas similares, el futuro de la infraestructura de IA podría depender cada vez menos de un único fabricante de chips.